
Transformers documentation
FastSpeech2Conformer
该模型于 2020-10-26 在 HF papers 上发布,并于 2024-01-03 贡献至 Hugging Face Transformers。
FastSpeech2Conformer
概述
FastSpeech2Conformer 模型由 Pengcheng Guo、Florian Boyer、Xuankai Chang、Tomoki Hayashi、Yosuke Higuchi、Hirofumi Inaguma、Naoyuki Kamo、Chenda Li、Daniel Garcia-Romero、Jiatong Shi、Jing Shi、Shinji Watanabe、Kun Wei、Wangyou Zhang 和 Yuekai Zhang 在论文 Recent Developments On Espnet Toolkit Boosted By Conformer 中提出。
原始 FastSpeech2 论文的摘要如下:
非自回归文本转语音(TTS)模型,例如 FastSpeech(Ren et al., 2019),能够以与先前自回归模型相当的质量,显著更快地合成语音。FastSpeech 模型的训练依赖于一个自回归教师模型来进行时长预测(以提供更多输入信息)和知识蒸馏(以简化输出中的数据分布),这有助于缓解 TTS 中的一对多映射问题(即多种语音变体对应同一段文本)。然而,FastSpeech 存在几个缺点:1)教师-学生蒸馏流程复杂且耗时;2)从教师模型中提取的时长不够准确,且从教师模型蒸馏出的目标梅尔频谱因数据简化而存在信息损失,这两点都限制了语音质量。在本文中,我们提出了 FastSpeech 2,它通过以下方式解决了 FastSpeech 中的问题,并更好地解决了 TTS 中的一对多映射问题:1)直接使用真实目标(ground-truth target)而非教师模型的简化输出来训练模型;2)引入更多语音变化信息(例如音高、能量以及更准确的时长)作为条件输入。具体而言,我们从语音波形中提取时长、音高和能量,并在训练时直接将其作为条件输入,在推理时使用预测值。我们进一步设计了 FastSpeech 2s,这是首次尝试并行地从文本直接生成语音波形,从而享有完全端到端推理的优势。实验结果表明:1)FastSpeech 2 相比 FastSpeech 实现了 3 倍的训练加速,而 FastSpeech 2s 拥有更快的推理速度;2)FastSpeech 2 和 2s 在语音质量上优于 FastSpeech,且 FastSpeech 2 甚至可以超越自回归模型。音频样本可在 https://speechresearch.github.io/fastspeech2/ 获取。
该模型由 Connor Henderson 贡献。原始代码可在此处找到。
🤗 模型架构
实现了 FastSpeech2 的通用结构,其中包含 Mel 频谱图解码器,并且像 ESPnet 库中那样,将传统的 transformer 块替换为 conformer 块。
FastSpeech2 模型架构

Conformer 块

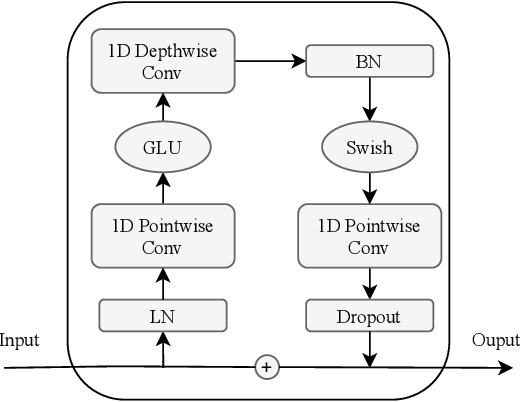
卷积模块
🤗 Transformers 用法
您可以使用 🤗 Transformers 库在本地运行 FastSpeech2Conformer。
- 首先安装 🤗 Transformers 库 和 g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- 使用 Transformers 建模代码,分别通过模型和 hifigan 运行推理
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- 通过 Transformers 建模代码运行推理,将模型与 hifigan 结合使用
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- 使用 pipeline 运行推理并指定要使用的 vocoder
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
class transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
参数
- is_encoder_decoder (
bool,可选,默认为True) — 指示该模型是否用作编码器/解码器。 - hidden_size (
int,可选,默认为384) — 隐藏表示的维度。 - vocab_size (
int,可选,默认为78) — 模型的词汇表大小。定义了input_ids可以表示的不同 token 的数量。 - num_mel_bins (
int,可选,默认为80) — 每个输入帧使用的 mel 特征数量。应与AutoFeatureExtractor类中使用的值相对应。 - encoder_num_attention_heads (
int,可选,默认为 2) — 编码器中注意力头的数量。 - encoder_layers (
int,可选,默认为4) — Transformer 编码器中的隐藏层数量。如果未设置,将使用与num_layers相同的值。 - encoder_linear_units (
int,可选,默认为 1536) — 编码器线性层中的单元数量。 - decoder_layers (
int, 可选,默认为4) — Transformer 解码器中的隐藏层数量。如果未设置,将使用与num_layers相同的值。 - decoder_num_attention_heads (
int,可选,默认为2) — Transformer 解码器中每个注意力层的注意力头数量。 - decoder_linear_units (
int,可选,默认为 1536) — 解码器线性层中的单元数量。 - speech_decoder_postnet_layers (
int, 可选,默认为 5) — 语音解码器后网络(post-net)的层数。 - speech_decoder_postnet_units (
int,可选,默认值为 256) — 语音解码器后网络层中的单元数量。 - speech_decoder_postnet_kernel (
int,可选,默认值为 5) — 语音解码器后处理网络(post-net)中的卷积核大小。 - positionwise_conv_kernel_size (
int,可选,默认为 3) — 逐位置层中使用的卷积核大小。 - encoder_normalize_before (
bool,可选,默认为False) — 指定是否在编码器层之前进行归一化。 - decoder_normalize_before (
bool,可选,默认为False) — 指定是否在解码器层之前进行归一化。 - encoder_concat_after (
bool,可选,默认为False) — 指定是否在编码器层之后进行拼接。 - decoder_concat_after (
bool,可选,默认为False) — 指定是否在解码器层之后进行拼接。 - reduction_factor (
int,可选,默认为 1) — 用于降低语音帧率的因子。 - speaking_speed(
float,可选,默认值为 1.0)—— 生成语音的速度。 - use_macaron_style_in_conformer (
bool,可选,默认为True) — 指定是否在 conformer 中使用 macaron 风格。 - use_cnn_in_conformer (
bool,可选,默认为True) — 指定是否在 conformer 中使用卷积神经网络。 - encoder_kernel_size (
int,可选,默认为 7) — 编码器中使用的卷积核大小。 - decoder_kernel_size (
int,可选,默认为 31) — 解码器中使用的卷积核大小。 - duration_predictor_layers (
int,可选,默认为 2) — 时长预测器中的层数。 - duration_predictor_channels (
int,可选,默认为 256) — 时长预测器中的通道数。 - duration_predictor_kernel_size (
int,可选,默认为 3) — 时长预测器中使用的卷积核大小。 - energy_predictor_layers (
int, 可选,默认为 2) — 能量预测器的层数。 - energy_predictor_channels (
int,可选,默认为 256) — 能量预测器中的通道数。 - energy_predictor_kernel_size (
int, 可选,默认为 3) — 能量预测器中使用的卷积核大小。 - energy_predictor_dropout (
float,可选,默认值为 0.5) — 能量预测器中的 dropout 率。 - energy_embed_kernel_size (
int,可选,默认为 1) — 能量嵌入层中使用的卷积核大小。 - energy_embed_dropout (
float,可选,默认值为 0.0) — 能量嵌入层中的 dropout 率。 - stop_gradient_from_energy_predictor (
bool,可选,默认为False) — 指定是否停止来自能量预测器的梯度。 - pitch_predictor_layers (
int, 可选,默认为 5) — 音高预测器的层数。 - pitch_predictor_channels (
int, 可选,默认为 256) — 音高预测器的通道数。 - pitch_predictor_kernel_size (
int,可选,默认为 5) — 音高预测器中使用的卷积核大小。 - pitch_predictor_dropout (
float, 可选,默认为 0.5) — 音高预测器中的 dropout 率。 - pitch_embed_kernel_size (
int, 可选,默认为 1) — 音高嵌入层中使用的卷积核大小。 - pitch_embed_dropout (
float,可选,默认值为 0.0) — 音高嵌入层的 dropout 率。 - stop_gradient_from_pitch_predictor (
bool,可选,默认为True) — 指定是否停止来自音高预测器的梯度。 - encoder_dropout_rate (
float,可选,默认值为 0.2) — 编码器中的 dropout 率。 - encoder_positional_dropout_rate (
float,可选,默认值为 0.2) — 编码器中的位置 dropout 率。 - encoder_attention_dropout_rate (
float,可选,默认值为 0.2) — 编码器中的注意力 dropout 率。 - decoder_dropout_rate (
float,可选,默认值为 0.2) — 解码器中的 dropout 率。 - decoder_positional_dropout_rate (
float,可选,默认值为 0.2) — 解码器中的位置 dropout 率。 - decoder_attention_dropout_rate (
float,可选,默认值为 0.2) — 解码器中的注意力 dropout 率。 - duration_predictor_dropout_rate (
float,可选,默认为 0.2) — 时长预测器中的 dropout 率。 - speech_decoder_postnet_dropout (
float,可选,默认值为 0.5) — 语音解码器后网络中的 dropout 率。 - max_source_positions (
int,可选,默认为 5000) — 如果使用"relative"位置嵌入,则定义源输入的最大位置数。 - use_masking (
bool,可选,默认为True) — 指定是否在模型中使用掩码。 - use_weighted_masking (
bool,可选,默认为False) — 指定是否在模型中使用加权掩码。 - num_speakers (
int, 可选) — 说话人数量。如果设置为 > 1,则假定说话人 ID 将作为输入提供,并使用说话人 ID 嵌入层。 - num_languages (
int, 可选) — 语言数量。如果设置为 > 1,则假定语言 ID 将作为输入提供,并使用语言 ID 嵌入层。 - speaker_embed_dim (
int, 可选) — 说话人嵌入维度。如果设置为 > 0,则假定将提供 speaker_embedding 作为输入。 - convolution_bias (
bool,可选,默认为True) — 指定 conformer 的卷积模块中的卷积是否使用偏置。
这是用于存储 FastSpeech2ConformerModel 配置的类。它根据指定的参数实例化 Fastspeech2 Conformer 模型,并定义模型架构。使用默认值实例化配置将得到与 espnet/fastspeech2_conformer 类似的配置。
配置对象继承自 PreTrainedConfig,可用于控制模型输出。有关更多信息,请参阅 PreTrainedConfig 的文档。
示例:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
类 transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
参数
- model_in_dim (
int,可选,默认为 80) — 输入对数梅尔频谱图中的频率分箱数量。 - upsample_initial_channel (
int, 可选,默认为 512) — 上采样网络的输入通道数。 - upsample_rates (
tuple[int]或list[int],可选,默认为[8, 8, 2, 2]) — 一个整数元组,用于定义上采样网络中每个一维卷积层的步长。upsample_rates 的长度决定了卷积层的数量,并且必须与 upsample_kernel_sizes 的长度相匹配。 - upsample_kernel_sizes (
tuple[int]或list[int],可选,默认为[16, 16, 4, 4]) — 一个整数元组,用于定义上采样网络中每个一维卷积层的卷积核大小。upsample_kernel_sizes 的长度定义了卷积层的数量,并且必须与 upsample_rates 的长度相匹配。 - resblock_kernel_sizes (
tuple[int]或list[int],可选,默认为[3, 7, 11]) — 一个整数元组,用于定义多感受野融合(MRF)模块中一维卷积层的卷积核大小。 - resblock_dilation_sizes (
tuple[tuple[int]]或list[list[int]],可选,默认为[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — 一个嵌套的整数元组,用于定义多感受野融合(MRF)模块中膨胀一维卷积层的膨胀率。 - initializer_range (
float,可选,默认为0.01) — 用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。 - leaky_relu_slope (
float,可选,默认为 0.1) — Leaky ReLU 激活函数所使用的负斜率角度。 - normalize_before (
bool,可选,默认为True) — 是否在使用声码器进行声码化之前,利用声码器学习到的均值和方差对频谱图进行归一化。
这是用于存储 FastSpeech2ConformerModel 配置的类。它根据指定的参数实例化 Fastspeech2 Conformer 模型,并定义模型架构。使用默认值实例化配置,将得到与 espnet/fastspeech2_conformer_with_hifigan 类似的配置。
配置对象继承自 PreTrainedConfig,可用于控制模型输出。有关更多信息,请参阅 PreTrainedConfig 的文档。
示例:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
class transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
这是用于存储 FastSpeech2ConformerModel 配置的类。它根据指定的参数实例化 Fastspeech2 Conformer 模型,并定义模型架构。使用默认值实例化配置,将得到与 espnet/fastspeech2_conformer_with_hifigan 类似的配置。
配置对象继承自 PreTrainedConfig,可用于控制模型输出。有关更多信息,请参阅 PreTrainedConfig 的文档。
示例:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
class transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
参数
- vocab_file (
str) — 词汇表文件的路径。 - bos_token(
str,可选,默认为"<sos/eos>") — 序列起始标记。请注意,对于 FastSpeech2,它与eos_token相同。 - eos_token (
str,可选,默认为"<sos/eos>") — 序列结束标记。请注意,对于 FastSpeech2,它与bos_token相同。 - pad_token (
str,可选,默认为"<blank>") — 用于填充的标记,例如在对长度不同的序列进行批处理时。 - unk_token (
str,可选,默认为"<unk>") — 未知标记。不在词汇表中的标记无法转换为 ID,因此会被设置为该标记。 - should_strip_spaces (
bool,可选,默认为False) — 是否去除 token 列表中的空格。
构建一个 FastSpeech2Conformer 分词器。
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
参数
- text (
str、list[str]、list[list[str]]、可选) — 要编码的序列或序列批次。每个序列可以是字符串或字符串列表(预分词字符串)。如果以字符串列表(预分词)形式提供序列,则必须设置is_split_into_words=True(以消除与序列批次的歧义)。 - text_pair (
str、list[str]、list[list[str]]、可选) — 要编码的序列或序列批次。每个序列可以是字符串或字符串列表(预分词字符串)。如果以字符串列表(预分词)形式提供序列,则必须设置is_split_into_words=True(以消除与序列批次的歧义)。 - text_target (
str、list[str]、list[list[str]]、可选) — 要编码为目标文本的序列或序列批次。每个序列可以是字符串或字符串列表(预分词字符串)。如果以字符串列表(预分词)的形式提供序列,则必须设置is_split_into_words=True(以消除与序列批次的歧义)。 - text_pair_target (
str、list[str]、list[list[str]]、可选) — 要编码为目标文本的序列或序列批次。每个序列可以是字符串或字符串列表(预分词字符串)。如果序列以字符串列表(预分词)的形式提供,则必须设置is_split_into_words=True(以消除与序列批次的歧义)。 - tokenizer_kwargs (
dict[str, Any], 可选) — 传递给 tokenizer 的额外 kwargs。这些 kwargs 将与显式参数及其他 kwargs 合并,其中显式参数具有更高的优先级。 - add_special_tokens (
bool,可选,默认为True) — 在编码序列时是否添加特殊标记。此操作将使用底层的PretrainedTokenizerBase.build_inputs_with_special_tokens函数,该函数定义了哪些标记会自动添加到输入 ID 中。如果您希望自动添加bos或eos标记,此功能非常有用。 - padding (
bool,str或 PaddingStrategy, ,可选, ,默认为False) — 启用并控制填充。接受以下值:True或'longest':填充至批次中最长的序列(如果仅提供单个序列,则不进行填充)。'max_length':填充至由参数max_length指定的最大长度;若未提供该参数,则填充至模型可接受的最大输入长度。False或'do_not_pad'(默认值):不进行填充(即可以输出包含不同长度序列的批次)。
- truncation (
bool,str或 TruncationStrategy, ,可选, ,默认为False) — 启用并控制截断。接受以下值:True或'longest_first':截断至由参数max_length指定的最大长度,或者如果未提供该参数,则截断至模型可接受的最大输入长度。这将逐个 token 进行截断,如果提供了一对序列(或一批序列对),则会从该对中最长的序列中移除一个 token。'only_first':截断至由参数max_length指定的最大长度,或者在未提供该参数时,截断至模型可接受的最大输入长度。如果提供了一对序列(或一批序列对),则仅截断其中的第一个序列。'only_second':截断至由参数max_length指定的最大长度,或者如果未提供该参数,则截断至模型可接受的最大输入长度。仅当提供了一对序列(或一批序列对)时,才会截断其中的第二个序列。False或'do_not_truncate'(默认值):不进行截断(即,可以输出序列长度大于模型最大可接受输入大小的批次)。
- max_length (
int, 可选) — 控制截断/填充参数之一所使用的最大长度。如果未设置或设置为 None,则当截断/填充参数需要最大长度时,将使用预定义的最大模型长度。如果模型没有特定的最大输入长度(如 XLNet),则禁用截断/填充到最大长度的功能。如果未设置或设置为
None,当截断/填充参数需要最大长度时,将使用预定义的最大模型长度。如果模型没有特定的最大输入长度(例如 XLNet),则禁用截断/填充至最大长度的功能。 - stride (
int,可选,默认为 0) — 如果与max_length一起设置为某个数值,则当return_overflowing_tokens=True时,返回的溢出 token 将包含截断序列末尾的若干 token,以在截断序列和溢出序列之间提供一定的重叠。此参数的值定义了重叠 token 的数量。 - is_split_into_words (
bool,可选,默认为False) — 输入是否已经预先分词(例如,已拆分为单词)。如果设置为True,分词器将假设输入已经拆分为单词(例如,通过按空白字符拆分),然后对其进行分词。这对于命名实体识别(NER)或 token 分类非常有用。 - pad_to_multiple_of (
int, 可选) — 如果设置,则将序列填充为所提供值的倍数。需要启用padding。 这对于在计算能力为>= 7.5(Volta)的 NVIDIA 硬件上启用 Tensor Cores 的使用特别有用。 - padding_side (
str, 可选) — 模型应应用填充的一侧。应在 [‘right’, ‘left’] 之间进行选择。 默认值取自同名的类属性。 - return_tensors (
str或 TensorType, 可选) — 如果设置,将返回张量而不是 Python 整数列表。可接受的值为:'pt':返回 PyTorchtorch.Tensor对象。'np':返回 Numpynp.ndarray对象。
- return_token_type_ids (
bool, 可选) — 是否返回 token type ID。如果保持默认值,将根据特定分词器的默认设置返回 token type ID,该设置由return_outputs属性定义。 - return_attention_mask (
bool, 可选) — 是否返回注意力掩码。如果保持默认值,将根据特定分词器的默认设置返回注意力掩码,该设置由return_outputs属性定义。 - return_overflowing_tokens (
bool,可选,默认为False) — 是否返回溢出的 token 序列。如果提供了输入 id 的序列对(或序列对批次),且truncation_strategy = longest_first或True,则会抛出错误,而不是返回溢出的 token。 - return_special_tokens_mask (
bool,可选,默认为False) — 是否返回特殊 token 掩码信息。 - return_offsets_mapping (
bool, 可选, 默认为False) — 是否返回(char_start, char_end)每个 token 的。此功能仅在继承自 PreTrainedTokenizerFast 的快速分词器上可用。如果使用 Python 分词器,此方法将抛出
NotImplementedError。 - return_length (
bool,可选,默认为False) — 是否返回编码后输入的长度。 - verbose (
bool,可选,默认为True) — 是否打印更多信息和警告。 - **kwargs — 传递给
self.tokenize()方法
返回值
一个包含以下字段的 BatchEncoding:
-
input_ids — 要输入模型的 token id 列表。
-
token_type_ids — 要输入模型的 token 类型 ID 列表(当
return_token_type_ids=True或self.model_input_names中包含 “token_type_ids” 时)。 -
attention_mask — 索引列表,指定模型应关注哪些 token(当
return_attention_mask=True或 “attention_mask” 位于self.model_input_names中时)。 -
overflowing_tokens — 溢出 token 序列的列表(当指定了
max_length且return_overflowing_tokens=True时)。 -
num_truncated_tokens — 被截断的 token 数量(当指定了
max_length且return_overflowing_tokens=True时)。 -
special_tokens_mask — 由 0 和 1 组成的列表,其中 1 表示添加的特殊标记,0 表示常规序列标记(当
add_special_tokens=True且return_special_tokens_mask=True时)。 -
length — 输入的长度(当
return_length=True时)
用于对一条或多条序列,或一对或多对序列进行分词并准备输入模型的主要方法。
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
将词汇表和特殊标记文件保存到目录中。
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
参数
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — 分词后的输入 ID 列表。可通过__call__方法获取。 - skip_special_tokens(
bool,可选,默认为False)— 是否在解码过程中移除特殊标记。 - clean_up_tokenization_spaces (
bool, 可选) — 是否清理分词空格。如果为None,则默认为self.clean_up_tokenization_spaces。 - kwargs(额外的关键字参数,可选) — 将传递给底层模型特定的解码方法。
返回值
list[str]
解码后的句子列表。
通过调用 decode,将 token id 的列表的列表转换为字符串列表。
此方法是为了向后兼容而提供的。decode 方法现在原生支持批量输入,因此您可以直接使用 decode 而无需使用 batch_decode。
FastSpeech2ConformerModel
class transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
参数
- config (FastSpeech2ConformerConfig) — 模型的配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 from_pretrained() 方法以加载模型权重。
FastSpeech2Conformer 模型。
该模型继承自 PreTrainedModel。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch torch.nn.Module 的子类。 请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
参数
- input_ids(形状为
(batch_size, sequence_length)的torch.LongTensor)— 输入文本向量序列。 - attention_mask (
torch.LongTensor形状为(batch_size, sequence_length), ,可选) — 用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 [0, 1]:1 表示未屏蔽的标记,0 表示被屏蔽的标记。什么是注意力掩码?[0, 1]:- 1 表示未被屏蔽的 token,
- 对于被掩码的 token,值为 0。
- spectrogram_labels (
torch.Tensor,形状为(batch_size, max_spectrogram_length, num_mel_bins),可选,默认为None) — 填充后的目标特征批次。 - duration_labels(形状为
(batch_size, sequence_length + 1)的torch.LongTensor,可选,默认为None) — 填充后的时长批次。 - pitch_labels(形状为
(batch_size, sequence_length + 1, 1)的torch.Tensor,可选,默认为None) — 填充后的按 token 平均的音高批次。 - energy_labels (
torch.Tensor,形状为(batch_size, sequence_length + 1, 1),可选,默认为None) — 一批填充后的 token 平均能量。 - speaker_ids(形状为
(batch_size, 1)的torch.LongTensor,可选,默认为None) — 用于条件化模型语音输出特征的说话人 ID。 - lang_ids (
torch.LongTensor,形状为(batch_size, 1),可选,默认为None) — 用于条件化模型语音输出特征的语种 ID。 - speaker_embedding (
torch.Tensor,形状为(batch_size, embedding_dim),可选,默认为None) — 包含语音特征条件信号的嵌入。 - return_dict (
bool, 可选) — 是否返回 ModelOutput 而不是普通元组。 - output_attentions (
bool, 可选) — 是否返回所有注意力层的注意力张量。有关详细信息,请参阅返回张量中的attentions。 - output_hidden_states (
bool,可选) — 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的hidden_states。
返回值
FastSpeech2ConformerModelOutput 或 tuple(torch.Tensor)
FastSpeech2ConformerModelOutput 或 torch.Tensor 元组(如果传入 return_dict=False 或 config.return_dict=False),包含根据配置(FastSpeech2ConformerConfig)和输入而定的各种元素。
FastSpeech2ConformerModel 的 forward 方法会重写 __call__ 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用
Module实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者则会静默地忽略这些步骤。
loss(形状为
(1,)的torch.Tensor,可选,在提供labels时返回)— 频谱图生成损失。频谱图(形状为
(batch_size, sequence_length, num_bins)的torch.Tensor,可选)— 预测的频谱图。encoder_last_hidden_state(形状为
(batch_size, sequence_length, hidden_size)的torch.Tensor,可选)— 模型编码器最后一层输出的隐藏状态序列。encoder_hidden_states (
tuple[torch.Tensor],可选,在传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个层输出的一个张量),形状为(batch_size, sequence_length, hidden_size)。编码器在每一层输出处的隐藏状态,以及初始嵌入输出。
encoder_attentions(
tuple[torch.Tensor],可选,当传入output_attentions=True或config.output_attentions=True时返回)—— 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。编码器在注意力 softmax 之后的注意力权重,用于在自注意力头中计算加权平均值。
decoder_hidden_states (
tuple[torch.Tensor],可选,在传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个层输出的一个张量),形状为(batch_size, sequence_length, hidden_size)。解码器在每一层输出处的隐藏状态,以及初始嵌入输出。
decoder_attentions(
tuple[torch.Tensor],可选,当传入output_attentions=True或config.output_attentions=True时返回)—— 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。解码器在注意力 softmax 之后的注意力权重,用于在自注意力头中计算加权平均值。
duration_outputs(形状为
(batch_size, max_text_length + 1)的torch.LongTensor,可选)— 时长预测器的输出。pitch_outputs(形状为
(batch_size, max_text_length + 1, 1)的torch.Tensor,可选)— 音高预测器的输出。energy_outputs(形状为
(batch_size, max_text_length + 1, 1)的torch.Tensor,可选)— 能量预测器的输出。
示例:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
class transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
参数
- config (FastSpeech2ConformerHifiGanConfig) — 模型配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 from_pretrained() 方法以加载模型权重。
HiFi-GAN 声码器。
该模型继承自 PreTrainedModel。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch torch.nn.Module 的子类。 请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
将 log-mel 频谱图转换为语音波形。传入一批 log-mel 频谱图将返回一批语音波形。传入单个未批处理的 log-mel 频谱图将返回单个未批处理的语音波形。
FastSpeech2ConformerWithHifiGan
class transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
参数
- config (FastSpeech2ConformerWithHifiGanConfig) — 模型的配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 from_pretrained() 方法以加载模型权重。
配备 FastSpeech2ConformerHifiGan 声码器头的 FastSpeech2ConformerModel,用于执行文本转语音(波形)。
该模型继承自 PreTrainedModel。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch torch.nn.Module 的子类。 请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
参数
- input_ids(形状为
(batch_size, sequence_length)的torch.LongTensor)— 输入文本向量序列。 - attention_mask (
torch.LongTensor形状为(batch_size, sequence_length), ,可选) — 用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 [0, 1]:1 表示未屏蔽的标记,0 表示被屏蔽的标记。什么是注意力掩码?[0, 1]:- 1 表示未被屏蔽的 token,
- 对于被掩码的 token,值为 0。
- spectrogram_labels (
torch.Tensor,形状为(batch_size, max_spectrogram_length, num_mel_bins),可选,默认为None) — 填充后的目标特征批次。 - duration_labels(形状为
(batch_size, sequence_length + 1)的torch.LongTensor,可选,默认为None) — 填充后的时长批次。 - pitch_labels(形状为
(batch_size, sequence_length + 1, 1)的torch.Tensor,可选,默认为None) — 填充后的按 token 平均的音高批次。 - energy_labels (
torch.Tensor,形状为(batch_size, sequence_length + 1, 1),可选,默认为None) — 一批填充后的 token 平均能量。 - speaker_ids(形状为
(batch_size, 1)的torch.LongTensor,可选,默认为None) — 用于条件化模型语音输出特征的说话人 ID。 - lang_ids (
torch.LongTensor,形状为(batch_size, 1),可选,默认为None) — 用于条件化模型语音输出特征的语种 ID。 - speaker_embedding (
torch.Tensor,形状为(batch_size, embedding_dim),可选,默认为None) — 包含语音特征条件信号的嵌入。 - return_dict (
bool, 可选) — 是否返回 ModelOutput 而不是普通元组。 - output_attentions (
bool, 可选) — 是否返回所有注意力层的注意力张量。有关详细信息,请参阅返回张量中的attentions。 - output_hidden_states (
bool,可选) — 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的hidden_states。
返回值
FastSpeech2ConformerModelOutput 或 tuple(torch.Tensor)
FastSpeech2ConformerModelOutput 或 torch.Tensor 元组(如果传入 return_dict=False 或 config.return_dict=False),包含根据配置(FastSpeech2ConformerConfig)和输入而定的各种元素。
FastSpeech2ConformerWithHifiGan 的 forward 方法重写了 __call__ 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用
Module实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者则会静默地忽略这些步骤。
loss(形状为
(1,)的torch.Tensor,可选,在提供labels时返回)— 频谱图生成损失。频谱图(形状为
(batch_size, sequence_length, num_bins)的torch.Tensor,可选)— 预测的频谱图。encoder_last_hidden_state(形状为
(batch_size, sequence_length, hidden_size)的torch.Tensor,可选)— 模型编码器最后一层输出的隐藏状态序列。encoder_hidden_states (
tuple[torch.Tensor],可选,在传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个层输出的一个张量),形状为(batch_size, sequence_length, hidden_size)。编码器在每一层输出处的隐藏状态,以及初始嵌入输出。
encoder_attentions(
tuple[torch.Tensor],可选,当传入output_attentions=True或config.output_attentions=True时返回)—— 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。编码器在注意力 softmax 之后的注意力权重,用于在自注意力头中计算加权平均值。
decoder_hidden_states (
tuple[torch.Tensor],可选,在传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个层输出的一个张量),形状为(batch_size, sequence_length, hidden_size)。解码器在每一层输出处的隐藏状态,以及初始嵌入输出。
decoder_attentions(
tuple[torch.Tensor],可选,当传入output_attentions=True或config.output_attentions=True时返回)—— 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。解码器在注意力 softmax 之后的注意力权重,用于在自注意力头中计算加权平均值。
duration_outputs(形状为
(batch_size, max_text_length + 1)的torch.LongTensor,可选)— 时长预测器的输出。pitch_outputs(形状为
(batch_size, max_text_length + 1, 1)的torch.Tensor,可选)— 音高预测器的输出。energy_outputs(形状为
(batch_size, max_text_length + 1, 1)的torch.Tensor,可选)— 能量预测器的输出。
示例:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])